Автономные агенты выполнили 41% заказов с биржи фриланса на уровне людей
Когда около года назад стартовал бенчмарк Remote Labor Index, самая эффективная на тот момент система Manus успешно завершала лишь 2,5% профессиональных задач. Сегодня новая модель Fable 5.2 от Anthropic выполняет более 41% реальных фриланс-проектов с профессиональным качеством. Этот сдвиг напрямую бьет по операционным бюджетам компаний и юнит-экономике проектного аутсорсинга, заставляя руководителей сопоставлять затраты на автономный инференс со ставками внешних подрядчиков.
В бенчмарке Remote Labor Index, курируемом Scale Labs и Center for AI Safety, модель Fable 5.2 заняла верхнюю строчку с показателем успешности 41,3%. Столь резкий скачок в практическом исполнении меняет экономику аутсорсинга, превращая автономных агентов в прямую альтернативу пулам внештатных специалистов. Главный вопрос для корпоративных бюджетов заключается в том, способны ли автономные системы стабильно выдерживать подтвержденные профессиональные стандарты на длинных дистанциях или они продолжат сбоить на сложных многоэтапных процессах.
Сдвиг базового уровня в интеллектуальном труде
Remote Labor Index измеряет долю коммерческих заказов, которые автономные программные агенты выполняют на уровне, достаточном для приемки и оплаты реальными заказчиками. Датасет для оценки включает 240 завершенных проектов от 358 верифицированных профессионалов с платформы Upwork с совокупной рыночной стоимостью около $144 000. В пересчете на единичные метрики средний проект из тестовой выборки стоит $632,60 и требует у человека-фрилансера чуть менее 29 рабочих часов.
Для выполнения заданий тестируемые системы получают доступ к виртуальной среде со стандартным набором инструментов вроде Blender, GIMP или Audacity, а также к специализированному софту для генерации визуальных и аудиоматериалов.
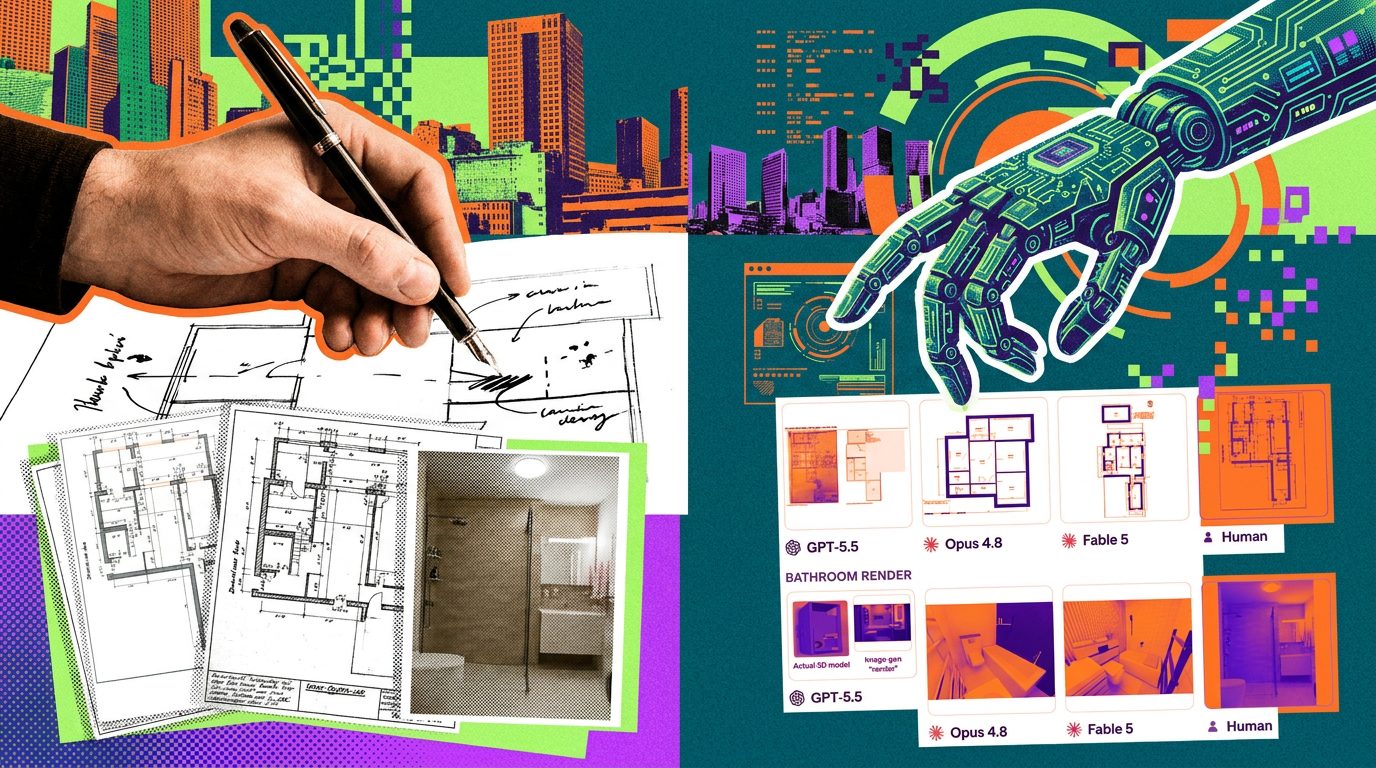
«Scale Labs констатирует, что Fable 5.2 совершила наибольший рывок в редактировании аудио и музыки, проектировании архитектуры и интерьеров, а также в создании 3D-моделей».
По данным команды тестирования Scale Labs, почти 50 успешных запусков Fable 5.2 пришлись на задачи, с которыми до этого не справилась ни одна автоматизированная система в рамках бенчмарка. Модель удерживает длинные цепочки рабочих процессов, на которых регулярно ломались архитектуры предыдущих поколений.
Разрыв в таблице лидеров
Разброс показателей между ведущими разработчиками демонстрирует растущую дифференциацию в качестве исполнения прикладных задач. Предыдущая модель Anthropic, Fable 5, в июле занимала первое место с результатом около 16%, а промежуточная Fable 5.1 остановилась на отметке чуть ниже 18%. Сейчас ближайшие конкуренты отстают с серьезным отрывом: Opus 5.5 от той же Anthropic набирает 21,25%, в то время как GPT 6 Astra от OpenAI показывает 20,83%.
Далее в рейтинге расположилась ведущая модель от Google в этом тесте — Gemini Argon 4, занявшая пятое место с 17,08%. Системы предыдущего поколения, включая GPT-5.2 и Gemini 3 Pro, на том же пуле задач не преодолевают планку в 3%.
Бенчмарк оценивает реальные профессиональные заказы стоимостью в сотни долларов, результаты которых вручную верифицируют профильные эксперты.
Квалифицированные ревьюеры анализируют итоговые файлы напрямую, открывая их в профессиональном софте и сопоставляя с работами людей-фрилансеров. Эту проверку невозможно переложить на алгоритмы: как отметили в Center for AI Safety, попытки автоматизировать оценку с помощью другого ИИ провалились. Автоматическим оценщикам не хватает компетенций для технического аудита проектов внутри специализированных программ, из-за чего они пропускают внешне эффектные работы, содержащие фатальные инженерные ошибки.
Дефицит надежности в боевых процессах
Структурные ошибки исполнения остаются главным барьером перед полной заменой внешних подрядчиков. Фиксируя сбои агентов в Remote Labor Index, исследователи отмечают регулярную сдачу дилетантских работ, неполную комплектацию проектов, поврежденные рабочие файлы или внутренне противоречивые технические решения. Согласно отчету Scale Labs, автономные агенты по-прежнему с трудом справляются с отдельными творческими направлениями, в первую очередь с промышленным дизайном и сложной анимацией.
Что было раньше
Отметка в $632,60 за проект на Upwork очерчивает порог, где автономным агентам уже доверяют не просто генерацию черновиков, а завершенную работу под ключ. За этим прогрессом скрывается жесткое узкое горлышко: проверять результаты машинного труда все еще приходится квалифицированным людям, ведь попытки поручить аудит другому ИИ привели к пропуску скрытых фатальных ошибок. Автономный агент уже готов забрать треть чужих заказов, но без живого эксперта с софтом на приемке компания рискует оплатить внешне блестящий, а внутри наглухо сломанный проект.
Наши материалы: Claude Fable 5 против ROI: ловушка стоимости Anthropic (9 июля).
Источник: The Decoder