Почему расходы на хранение данных для ИИ обогнали траты на GPU?
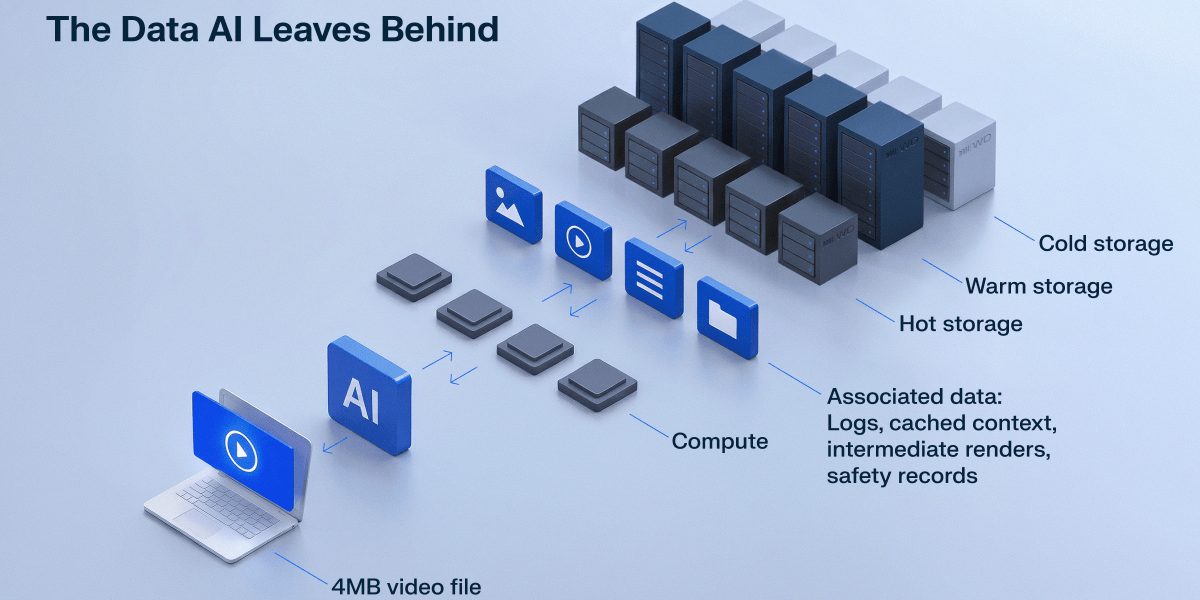
Если попросить большинство руководителей оценить затраты на искусственный интеллект, они, скорее всего, представят стойки с энергоемкими GPU и бесконечную очередь на поставку кремния. Но эта ментальная модель упускает из виду скрытую статью расходов: хранение данных. Что происходит с информацией после ответа модели? Большая часть бэкенд-данных, генерируемых миллиардами ежедневных запросов, изображений и видео, должна храниться бессрочно. В отличие от предсказуемых циклов обучения с четким началом и концом, инференс работает непрерывно каждый раз, когда модель отвечает на запрос, оставляя после себя постоянный цифровой след.
В качестве примера можно привести рабочие нагрузки по созданию видео с помощью искусственного интеллекта, где затраты на бэкенд растут из-за огромного объема сопутствующих технических артефактов. Как пояснил старший продакт-менеджер гипермасштабируемого облачного провайдера в недавнем отчете, наличие большего объема памяти служит необходимым буфером для загрузки дорогих GPU. Он отметил, что главная операционная сложность заключается в том, чтобы кремний никогда не простаивал из-за ожидания данных, поскольку часы простоя GPU очень быстро сжигают капитал.
Дополнительное хранилище можно рассматривать как способ оптимизации для постоянной загрузки GPU
Если говорить строгим финансовым языком, то при росте затрат на корпоративное хранение данных на 25% в год, в то время как бюджеты на вычисления развиваются циклично и предсказуемо, хранение в конечном итоге опережает инфраструктурную статью, получающую львиную долю внимания руководства.
Лавина генеративных бэкенд-данных
Внутренние измерения Western Digital показали, что 8-клип, возвращенный пользователю в виде скромного файла 720p размером 3,97 МБ, оставляет на бэкенде более 500 МБ сопутствующих технических данных. Это представляет собой поразительный 130-кратный рост по сравнению с размером выходного файла, видимого конечным пользователем. Масштабирование этого объема для компании, генерирующей более длинное видео высокого разрешения, увеличивает объем бэкенда до сотен гигабайт на один клип. По прогнозам McKinsey, спрос на инференс искусственного интеллекта будет расти со среднегодовым темпом роста в 35% до 2030 года по сравнению с 22% для обучения, в результате чего к концу десятилетия инференс составит более 40% от общего спроса дата-центров.
Признание этого расширения инфраструктуры во всей индустрии подтверждается глобальным отчетом IDC, спонсируемым Western Digital, в котором приняли участие 763 ИТ- и бизнес-руководителя. Почти 95% респондентов сообщили об увеличении объемов данных, напрямую связанных с генеративным искусственным интеллектом, за последние 12 месяцев, причем около 61% сообщили о темпах роста на 25% и более. Кроме того, 96% респондентов ожидают, что им потребуется более высокая скорость извлечения архивов только для поддержки текущих конвейеров инференса или генерации с дополненной выборкой (RAG).
Пересчет совокупной стоимости владения
Потребность в вычислениях растет и падает вместе с циклами обучения, запусками продуктов и обновлением оборудования, но объем хранимых данных никогда не снижается при плато спроса на вычисления. Журналы моделей, синтетические результаты и результаты инференса неуклонно накапливаются, поскольку организации хранят данные в течение более длительных периодов. Для огромных объемов информации, которые необходимо сохранять и периодически просматривать, жесткие диски обеспечивают экономичную основу большой емкости, сохраняя решающее преимущество в стоимости за терабайт по сравнению с флеш-памятью.
Команда руководителей, которая планирует бюджет на искусственный интеллект строго как расходы на вычисления плюс погрешность на хранение, попадает в ловушку. Эта погрешность неизбежно раздувается до значительной доли от общих затрат программы в течение 12–18 месяцев — как раз в тот момент, когда руководство садится за стол переговоров, чтобы решить, расширять ли инициативу или сворачивать ее.
Анализ редакции
Что подтверждено
По данным Western Digital, 8-секундный клип 720p на 3,97 МБ оставляет более 500 МБ бэкенд-данных, почти 95% респондентов фиксируют рост объемов данных из-за генеративного AI за последний год, а McKinsey прогнозирует ежегодный рост спроса на инференс AI в 35% до 2030 года против 22% для обучения.
Источник: MIT Technology Review