Теоретические расчеты FLOP — дорогостоящие простои серверов NVIDIA H200
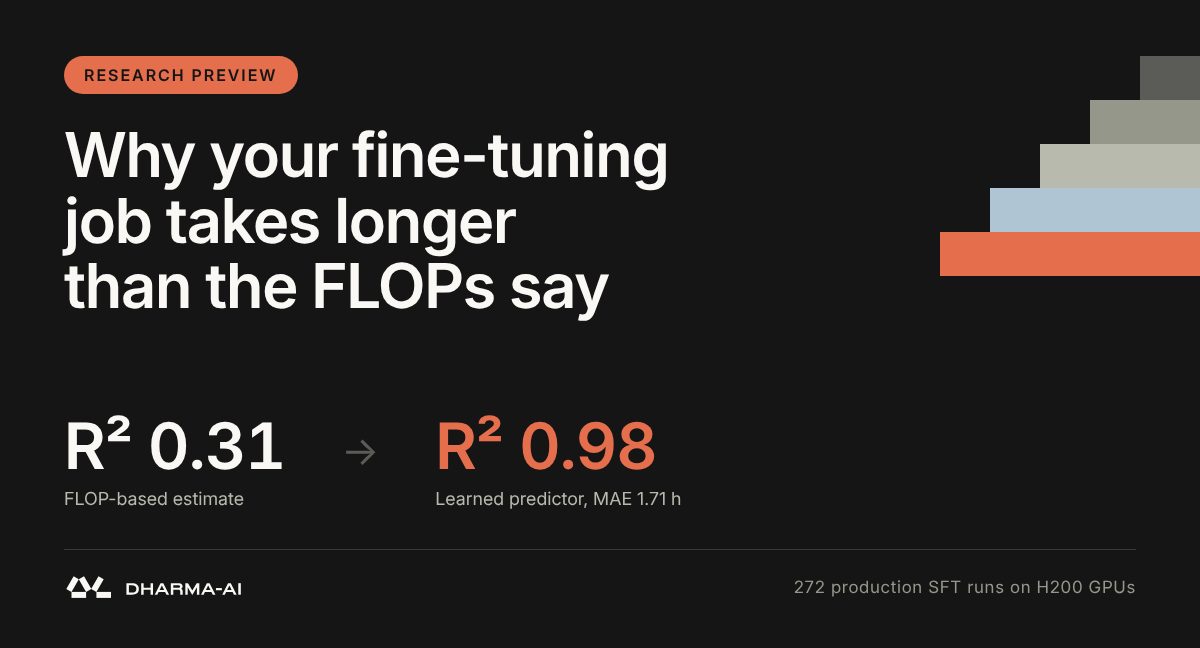
Стандартное планирование инфраструктуры опирается на теоретические формулы вычислений, однако эмпирические замеры на базе 272 задач контролируемого дообучения (supervised fine-tuning) на графических процессорах NVIDIA H200 показали, что классические расчеты расходятся с реальным временем завершения на десятки часов. Корпоративные инженерные команды распределяют аппаратные ресурсы исходя из математики операций с плавающей запятой, полагая, что затраты на обновление параметров напрямую конвертируются в физическое астрономическое время исполнения. Тем не менее классические расчеты через операции с плавающей запятой игнорируют накладные расходы кластера, превращая планирование мощностей GPU в дорогостоящую лотерею. Когда рабочие нагрузки выполняются на общей инфраструктуре, разрыв между арифметической пропускной способностью и календарным временем определяет, принесет ли оборудование возврат на капитал или останется заблокированным между запусками задач.
Почему реальная продолжительность дообучения многократно превышает теоретические оценки? Несоответствие кроется во всех процессах, происходящих за пределами цикла оптимизации модели: токенизация, загрузка данных, извлечение артефактов и инициализация окружения поглощают ценные мощности еще до того, как начинается активное обучение.
Провал чистых вычислительных формул
Аналитические модели производительности оценивают работу трансформеров через теоретические пределы. Для плотного (dense) трансформера вычислительные затраты цикла оптимизации грубо составляют 6, умноженное на количество параметров и на число обучающих токенов.
«Если кратко: стандартная оценка на основе FLOP почти не объясняет увиденное нами на практике (R² = 0,31, MAE 12,41 ч).»
Деление этой арифметической нагрузки на паспортную пиковую производительность операций с плавающей запятой и коэффициент утилизации вычислительной мощности (Model FLOPs Utilization) дает теоретическое время выполнения. В производственных средах утилизация Model FLOPs обычно держится на уровне от 30% до 60%, причем точное значение остается неизвестным до момента запуска.
Как показал анализ эксплуатационных журналов, метрики операций с плавающей запятой систематически упускают операционные задержки. До старта вычислений кластеры выполняют инициализацию окружения, извлечение артефактов, загрузку весов и токенизацию датасета. Во время активного обучения задачи регулярно запускают процедуры валидации и сохранения контрольных точек (чекпоинтов) в общее хранилище, конкурируя с параллельными рабочими нагрузками на соседних узлах.
Эмпирические данные по 7 382 GPU-часам
Чтобы измерить эту структурную задержку, исследователи проанализировали журналы операций общим объемом около 7 382 GPU-часов. Выборка включила 272 запуска контролируемого дообучения для нескольких семейств архитектур размером до 15 миллиардов параметров, с использованием адаптаций LoRA и полнопараметрического обновления при различных профилях гиперпараметров.
Вычислительные ресурсы выделялись блоками по 1, 2 или 4 GPU из динамического пула объемом от 8 до 32 ускорителей H200, распределенных по 1–4 серверным узлам. Один из контраргументов гласит, что статическое выделение мощностей могло бы устранить вариативность кластера, сделав базовые арифметические формулы пригодными для составления производственных графиков. Однако статическая изоляция мощностей не устраняет внутренние системные требования задач, такие как конвейеры токенизации, сериализация состояний объемом в десятки гигабайт или промежуточные оценки моделей. Даже в условиях однородного оборудования невычислительные задачи приводят к существенным и нестабильным задержкам выполнения.
Коррекция стратегии распределения методами машинного обучения
Предиктивные модели машинного обучения сокращают разрыв в диспетчеризации за счет анализа параметров, известных строго до момента запуска, полностью исключая необходимость мониторинга журналов во время выполнения.
Регрессионная модель CatBoost, использующая 24 признака — включая частоту контрольных точек, масштаб сериализации параметров и объем процедур валидации наряду с базовыми вычислениями, — достигает показателя R² на уровне 0,98.
«Точные оценки длительности превращают процесс из гадания в планирование: что запускается, когда и на скольких GPU, исключая простой мощностей между задачами.»
При тестировании с помощью 5-кратной кросс-валидации модель регрессии показала медианную ошибку в 0,51 часа и среднюю абсолютную ошибку в 1,71 часа. Для сравнения: стандартные уравнения FLOP на тех же корпоративных нагрузках дают R² = 0,31 и среднюю ошибку в 12,41 часа.
Почему это важно
Непредвиденные финансовые потери и срыв графиков грозят инженерным командам всякий раз, когда расчет аренды мощностей строится на бумажной производительности ускорителей. Еще в конце августа выяснилось, почему расчеты через FLOP не отражают реальную скорость и затраты на ИИ, а свежие тесты на базе 272 запусков дообучения доказали масштаб проблемы на практике: отклонения от расчетного времени достигают десятков часов. Паспортная пиковая производительность чипов красиво смотрится в презентациях, но в реальном кластере треть времени уходит на то, чтобы просто скормить модели данные.
Наши материалы: Почему FLOPs не отражают реальную скорость и затраты на ИИ (24 августа).
Источник: HuggingFace Blog