Google TPU 8i Max удваивает плотность вычислений без перехода на новый техпроцесс
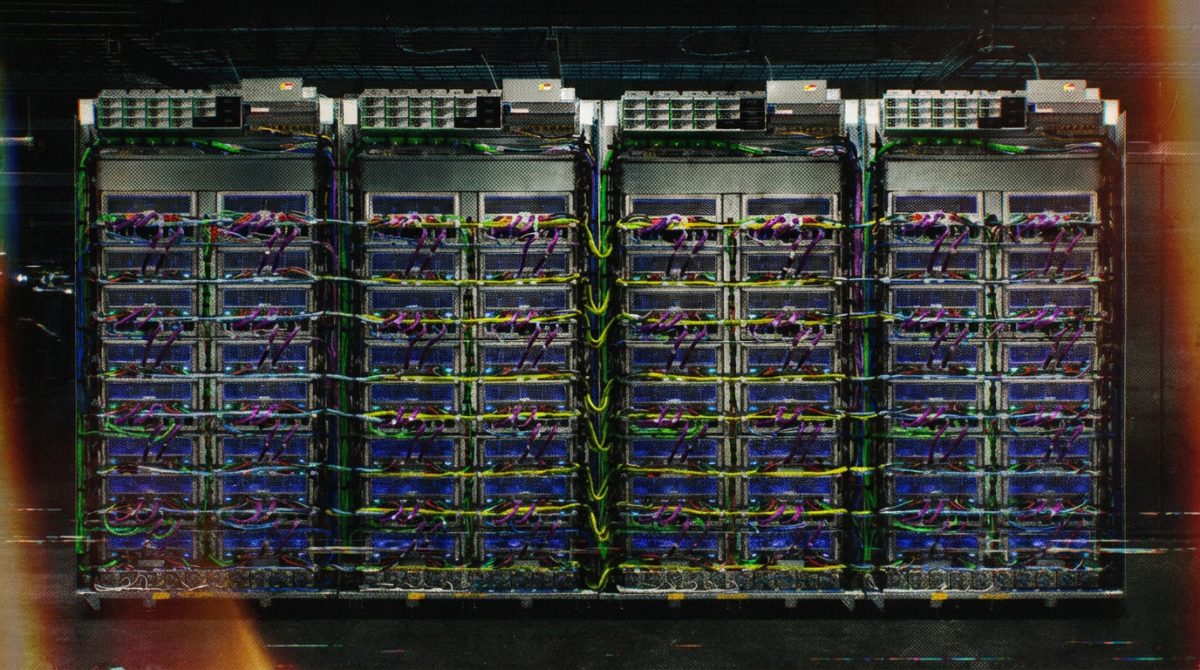
Google представила TPU 8tx и TPU 8i Max, расширив линейку AI-ускорителей восьмого поколения для пересмотра структуры затрат корпоративного инференса. По всей отрасли коммерческий фокус смещается с дорогостоящего обучения моделей на повседневное исполнение запросов, превращая закупку оборудования в постоянную операционную статью расходов. Впервые Google выпустила четыре конфигурации TPU за один календарный год, изменив тактику масштабирования аппаратной базы: компания сделала ставку на перекомпоновку уже существующего кремния вместо запуска следующего поколения процессоров.
Такая архитектура позволяет обойти типичные производственные циклы фабрикации чипов за счет модификации корпусирования, межчиповых межсоединений и распределения памяти вокруг базового процессорного ядра. Инженерные команды избегают многолетних этапов проектирования и подготовки производства (tape-out), используя модульный подход. По заявлению Google, эта схема позволяет выводить рабочие аппаратные модификации за месяцы, а не годы. Вместо продажи единого универсального вычислительного блока для каждой серверной стойки провайдер инфраструктуры поставляет таргетированные стоечные системы, рассчитывая перехватить у Nvidia внешние рабочие нагрузки инференса. Оптимизируя экономику закупок на базе уже выпущенного кремния, корпоративные дата-центры получают возможность наращивать мощности без ожидания новых технологических узлов.
Специализированный кремний против монолитных архитектур
Каждый представленный вариант закрывает конкретные архитектурные узкие места, раздувающие накладные расходы корпоративных ЦОД. Модель TPU 8tx решает задачи корпоративной безопасности данных, изолируя веса моделей и активные рабочие процессы так, чтобы информация оставалась зашифрованной непосредственно в ходе вычислений. Для регулируемых секторов подобное архитектурное решение предотвращает утечки данных без необходимости распределять потоки по физически изолированным кластерам.
TPU 8tx обеспечивает сквозное шифрование конфиденциальных данных в процессе обработки, тогда как TPU 8i Max удваивает объем памяти и вычислительную мощность в рамках стандартной стойки.
Контур непрерывного шифрования функционирует поверх сети с низкими задержками Boardfly, разработанной Google специально для инференса в реальном времени. Сеть рассчитана на двукратное снижение задержек по сравнению с TPU 8t предыдущей модификации, снимая проблему медленного отклика при масштабном развертывании моделей. В свою очередь, длинные контекстные окна и корпоративные AI-агенты сталкиваются с жесткими ограничениями пропускной способности при обработке обширных кодовых баз или видеопотоков. В качестве ответа Google объединила два чипа TPU 8i на одной физической подложке внутри системы TPU 8i Max. Новая сборка обеспечивает двукратный прирост вычислительной мощности, объема памяти и ее пропускной способности в габаритах прежней стойки, удваивая удельную производительность на квадратный метр площади ЦОД.
Программный уровень и барьеры экосистемы
Главным препятствием для миграции корпоративных заказчиков остается вопрос, смогут ли модульные заказные сборки потеснить устоявшуюся архитектуру дата-центров от Nvidia. Калифорнийский чипмейкер уже предлагает конфиденциальные вычисления на базе собственных GPU, удерживая доминирующие позиции за счет глубоко укоренившейся программной инфраструктуры. Чтобы снизить входной барьер, Google выпустила открытый инструмент TorchTPU, позволяющий исполнять стандартный код PyTorch на чипах TPU с минимальными правками, а также добавила нативную интеграцию с популярными движками инференса vLLM и SGLang.
Узкоспециализированные процессоры демонстрируют максимальную эффективность на рутинных задачах инференса в условиях, когда технологические гиганты форсируют развертывание собственных ускорителей.
Экспансия аппаратных конфигураций отражает общее стремление гиперскейлеров обуздать капитальные затраты на ускорители: собственные кремниевые решения параллельно развивают Amazon, Microsoft и OpenAI. В свою очередь, Nvidia укрепляет портфель решений для инференса за счет лицензионных соглашений и поглощения кадров стартапа Groq, стремясь защитить собственную маржинальность на фоне интереса покупателей к оптимизированным стоечным сборкам. На текущий момент платформа Google насчитывает порядка 100 внешних корпоративных клиентов, использующих инфраструктуру TPU.
Что не сходится
Google выпустила рекордные четыре конфигурации чипов за один год, но не спроектировала для них ни одного нового процессорного ядра. Вместо мучительного ожидания свежих кремниевых узлов инженеры просто перетасовали память и межчиповые связи на готовой базе — экономия времени колоссальная, вот только программный барьер никуда не делся. Одной лишь связки TorchTPU с движками vLLM и SGLang мало, когда вся индустрия годами бетонировала свои пайплайны вокруг решений Nvidia.
Источник: The Decoder