Nvidia GR00T 2: замена ручного телеуправления роботами видеогенерацией
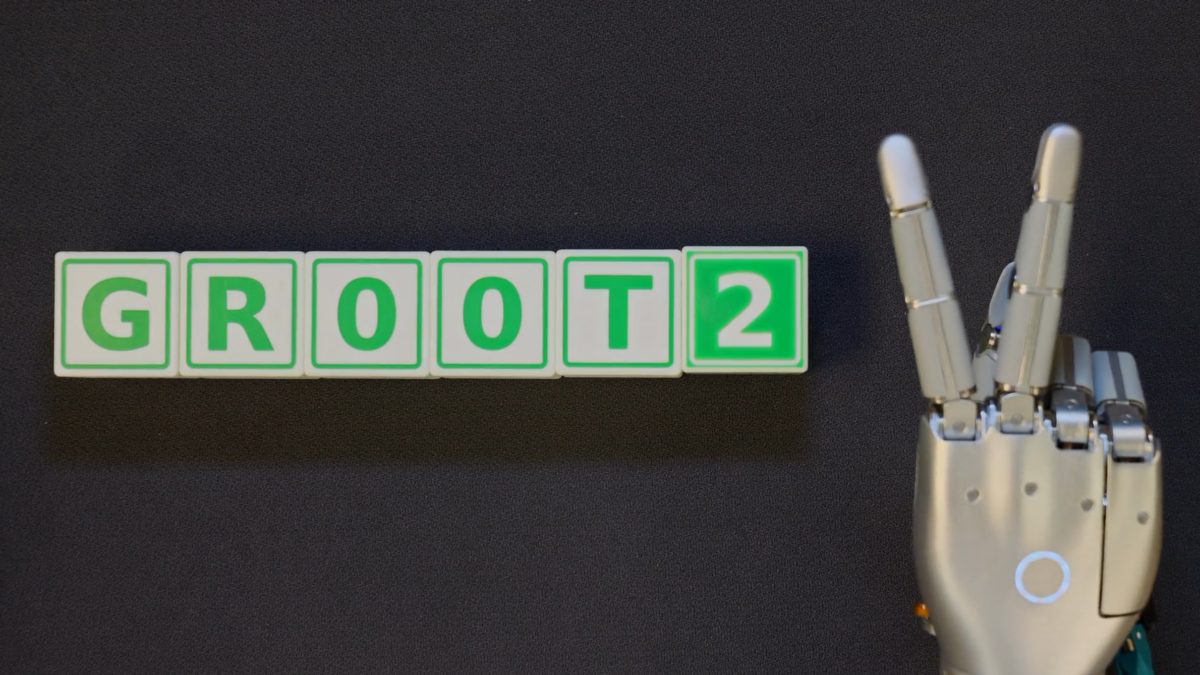
Способны ли промышленные предприятия отказаться от ручного дистанционного управления при обучении роботов-манипуляторов физическим операциям? Чтобы научить машины новым задачам, инженеры традиционно тратят сотни часов на прямое телеуправление оборудованием. Это операционное бутылочное горлышко обходится дорого, отнимает время и жестко привязывает алгоритмы к конкретной конфигурации железа. Nvidia представила базовую ИИ-модель GR00T 2, созданную для прямого переноса движений человека из видеозаписей на манипуляторы, что устраняет необходимость непрерывного ручного сопровождения при сборе обучающих датасетов.
Nvidia устраняет барьер телеопераций за счет переноса генерации движений в предиктивную визуальную архитектуру. В отличие от систем прошлого поколения, включая первую версию GR00T 1, новая модель не сопоставляет необработанные кадры с камер напрямую с командами сервоприводов. Как утверждают в компании, программный комплекс работает как модель мира и действия (world-action model): она параллельно рассчитывает следующее физическое движение и генерирует короткий видеоряд ближайшего будущего, прогнозируя визуальные изменения среды вроде захвата объекта клешней.
Генеративное видео вместо ручных часов
Для построения предиктивного конвейера Nvidia обучила систему GR00T 2 на вычислительном кластере из более чем 1000 чипов GB300. Датасет включил порядка 400 000 часов видеозаписей, на которых люди выполняют различные прикладные операции с закрепленными на голове камерами. После объединения с базовыми профилями движения целевого манипулятора архитектура генерирует изображение механической руки, заменяющей человеческую конечность, и рассчитывает соответствующие команды для приводов.
«Nvidia утверждает, что программный комплекс работает по принципу модели мира и действия. Он параллельно вычисляет следующее движение и короткий видеоряд ближайшего будущего».
В ходе контролируемых тестов пятипалый манипулятор сумел зажечь спичку, нарезать банан и сбросить посылки на ленту транспортера без предварительных сессий телеуправления под эти конкретные процессы. В отдельных автономных испытаниях доля успешных попыток колебалась от 10 до 80%, а симуляцию забивания гвоздей система построила на базе единственного видеоролика с движением руки человека. Однако, устраняя затраты труда инженеров на сбор данных, вендор не раскрывает метрики совокупной стоимости владения кластером GB300, расходов на датасеты и реальной долларовой экономии от отказа от ручных сессий.
Адресное дообучение и дефицит вычислений
Разрыв в эксплуатационной надежности компенсируется прямым физическим дообучением на месте. На выборке из 50 задач, где GR00T 2 показала базовый результат после нескольких демонстраций, менее трех минут стандартной калибровки повысили долю успешных операций с 40 до 95%.
Для многоэтапных сценариев Nvidia подключает к конвейеру модель рассуждений более высокого уровня, такую как GPT-6 Astra от OpenAI. Языковая модель разбивает задачу на последовательные этапы, определяет координаты захвата на видеопотоке и запускает алгоритмы устранения ошибок при падении деталей. Когда инженеры хаотично разбросали по столу элементы сборных моделей, гибридный комплекс собрал их минимум в 97% попыток. Без управляющей языковой модели и калибровки результативность системы на 100 тестах составила лишь 23%.
Для мобильных шасси инженеры сжали архитектуру до версии GR00T 2 Turbo, обрабатывающей кадры с меньшей детализацией. Модель исполняется непосредственно на бортовом компьютере Jetson Thor гуманоидного робота, обеспечивая базовую уборку: протирку столов, зачерпывание попкорна и вытирание пролитых жидкостей закрепленной на ноге салфеткой — действие завершилось успехом чуть менее чем в половине прогонов.
Архитектура обнажает жесткий инфраструктурный компромисс между точностью манипуляций и задержкой отклика. В тестах по сортировке мусора робот простаивал около трети общего рабочего времени: средняя пауза в ожидании расчетов от планирующей модели превышала семь секунд. Команда Nvidia также подтвердила, что конвейер пока не принимает прямые данные с тактильных датчиков и пропускает дефекты сборки вроде недокрученных винтов. Высокая задержка инференса и отсутствие осязания остаются главными барьерами для автономного внедрения, а реальная рентабельность архитектуры по-прежнему зависит от баланса между затратами на масштабные вычисления и расходами на ручную доводку на местах.
На фоне других
Какую цену бизнес платит за отказ от монотонных телеопераций при подготовке манипуляторов к работе? Вендор умалчивает общие расходы на поддержание такого конвейера и реальную экономию в долларах. Полная автономность манипулятора на поверку оборачивается необходимостью докупать стороннюю модель рассуждений и тратить время на ручную доводку прямо у конвейера.
Источник: The Decoder