Могут ли локальные компактные нейросети избавить бизнес от счетов за облачный ИИ?
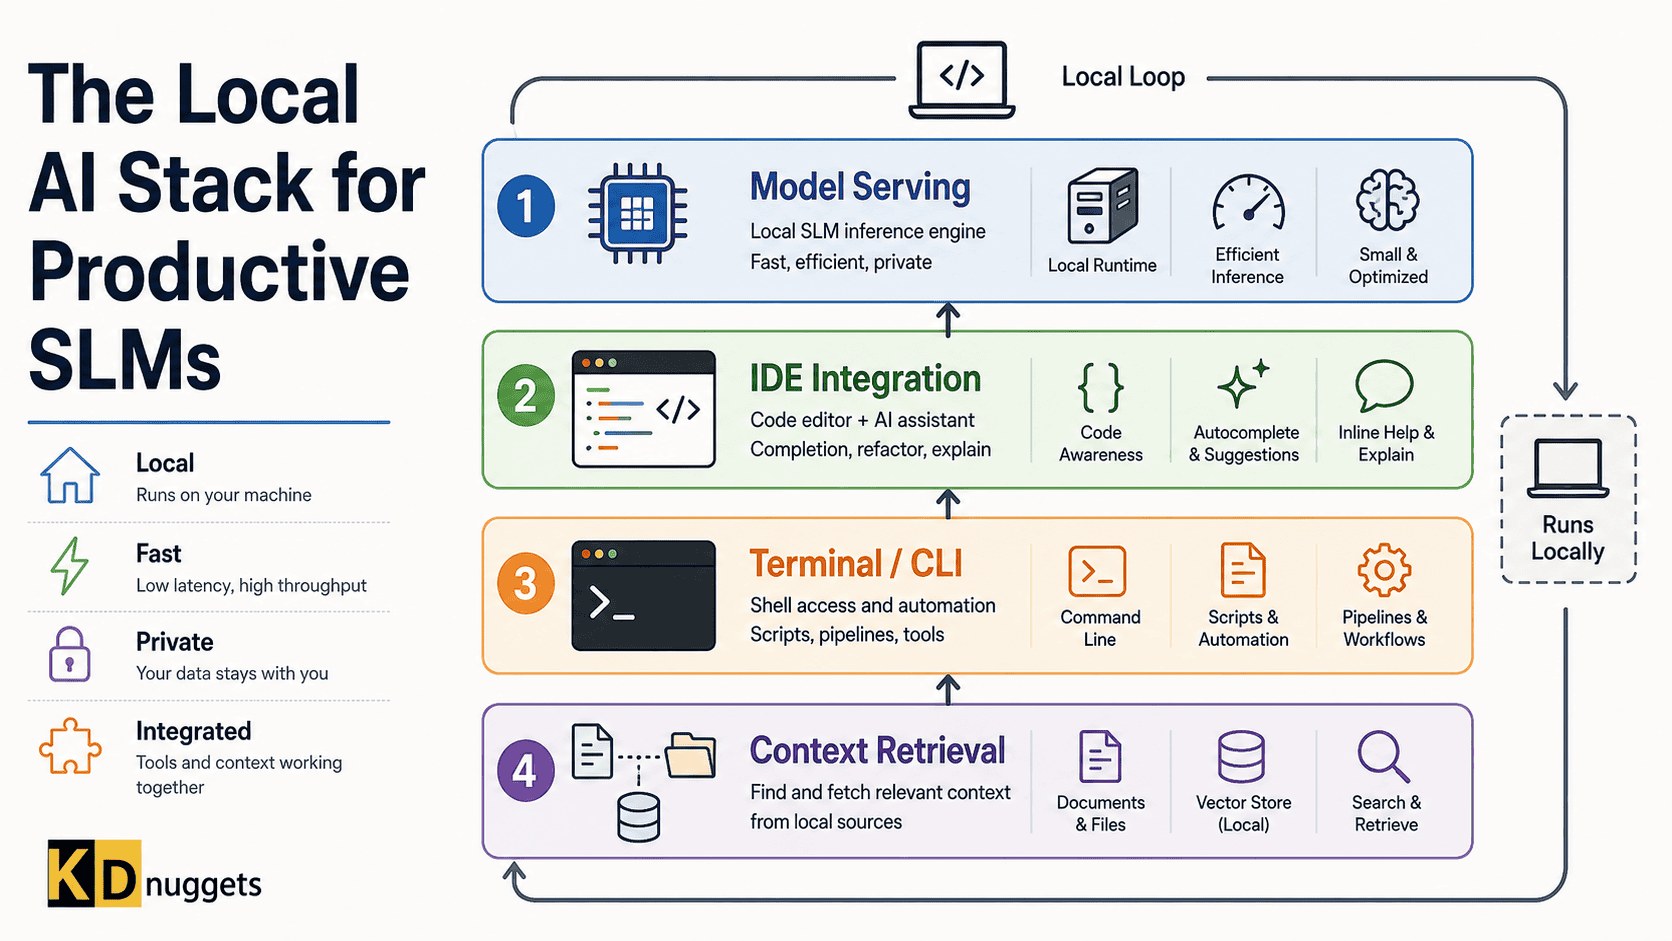
Развертывание открытых языковых моделей на собственном оборудовании превратилось из хобби энтузиастов в стандартное инженерное решение. Высокие счета за облачные API, требования к суверенитету данных и ограничения по задержке вынуждают инженерные команды переходить на компактные малые языковые модели (SLM) размером от 1 до 14 млрд параметров. Они без проблем запускаются на потребительских видеокартах с 8–24 ГБ видеопамяти или на объединенной памяти Apple Silicon. Однако генерация токенов в терминале бесконечно далека от отказоустойчивого корпоративного пайплайна инференса.
Выбор слоя инференса
В центре локальной архитектуры находится среда исполнения (serving runtime), которая управляет низкоуровневыми вычислительными ядрами, квантованием и конечными точками API. Ollama остается путем наименьшего сопротивления для рабочих станций отдельных разработчиков благодаря автоматическому обнаружению GPU и отсутствию настроек, предоставляя совместимый с OpenAI REST API. Для быстрой оценки неквантованных весов с Hugging Face подойдет LM Studio с удобным графическим интерфейсом, хотя она и создает лишние накладные расходы для фоновых задач в продакшене.
Промышленное внедрение требует четкого баланса между контролем над железом и пропускной способностью. Фундаментальный фреймворк llama.cpp обеспечивает гранулярный контроль над флагами компиляции, 4-битным и 8-битным квантованием GGUF, а также работой на периферийных устройствах. Для масштабирования на команды логичным выбором становится vLLM: алгоритм PagedAttention и непрерывное батчирование максимизируют эффективность памяти GPU и обрабатывают параллельные запросы без деградации контекстных окон.
«Пропасть между “модель ответила мне в терминале” и “у меня настроена локальная ИИ-система, которая реально улучшает работу” сводится исключительно к используемому инструментарию».
Понимание того, где вычислительные лимиты упираются в оркестрацию инференса, уберегает команды от избыточных затрат на инфраструктуру до замера базовых метрик задержки.
Интеграция моделей в среду разработки
Подключение движков инференса к реальным рабочим процессам в IDE требует надежного управления контекстом, локального RAG и стабильного вызова внешних инструментов (tool calling). Вместо простого автодополнения современный стек напрямую встраивает локальные SLM в автономные контуры написания кода.
Впрочем, маркетинговые заявления об автономности на собственных серверах требуют проверки реальностью. Запуск сложных агентных циклов на весах от 1 до 14 млрд параметров регулярно перегружает узкие контекстные окна и выявляет нестабильность многошагового рассуждения. Чтобы успешно заменить облачные аналоги, техническим лидерам придется вложиться в жесткий промптинг, валидацию структурированных JSON-схем и специализированное дообучение, а не рассчитывать на автономную работу сырых локальных моделей из коробки.
Источник: KDnuggets